
敏感文档处理的隐私挑战
在数字化办公时代,法律、财务、医疗等领域的专业人士经常需要处理合同、票据、报告等敏感图片文件。传统OCR(光学字符识别)工具通常要求用户将图片上传至远程服务器进行识别,这带来了显著的数据泄露风险。一旦敏感信息如客户数据、财务记录或机密条款被第三方服务器存储,可能遭遇黑客攻击、数据滥用或合规违规问题,尤其在涉及隐私法规如GDPR或HIPAA的行业,这种风险尤为突出。因此,寻找一种既能高效提取文字又能保障隐私安全的解决方案,成为许多专业人士的迫切需求。
纯前端OCR工具操作详解
为了应对隐私挑战,纯前端OCR工具应运而生,它完全在浏览器本地运行,图片无需离开您的设备。要使用这款工具,首先访问图片OCR页面,这是您安全处理敏感文档的起点。
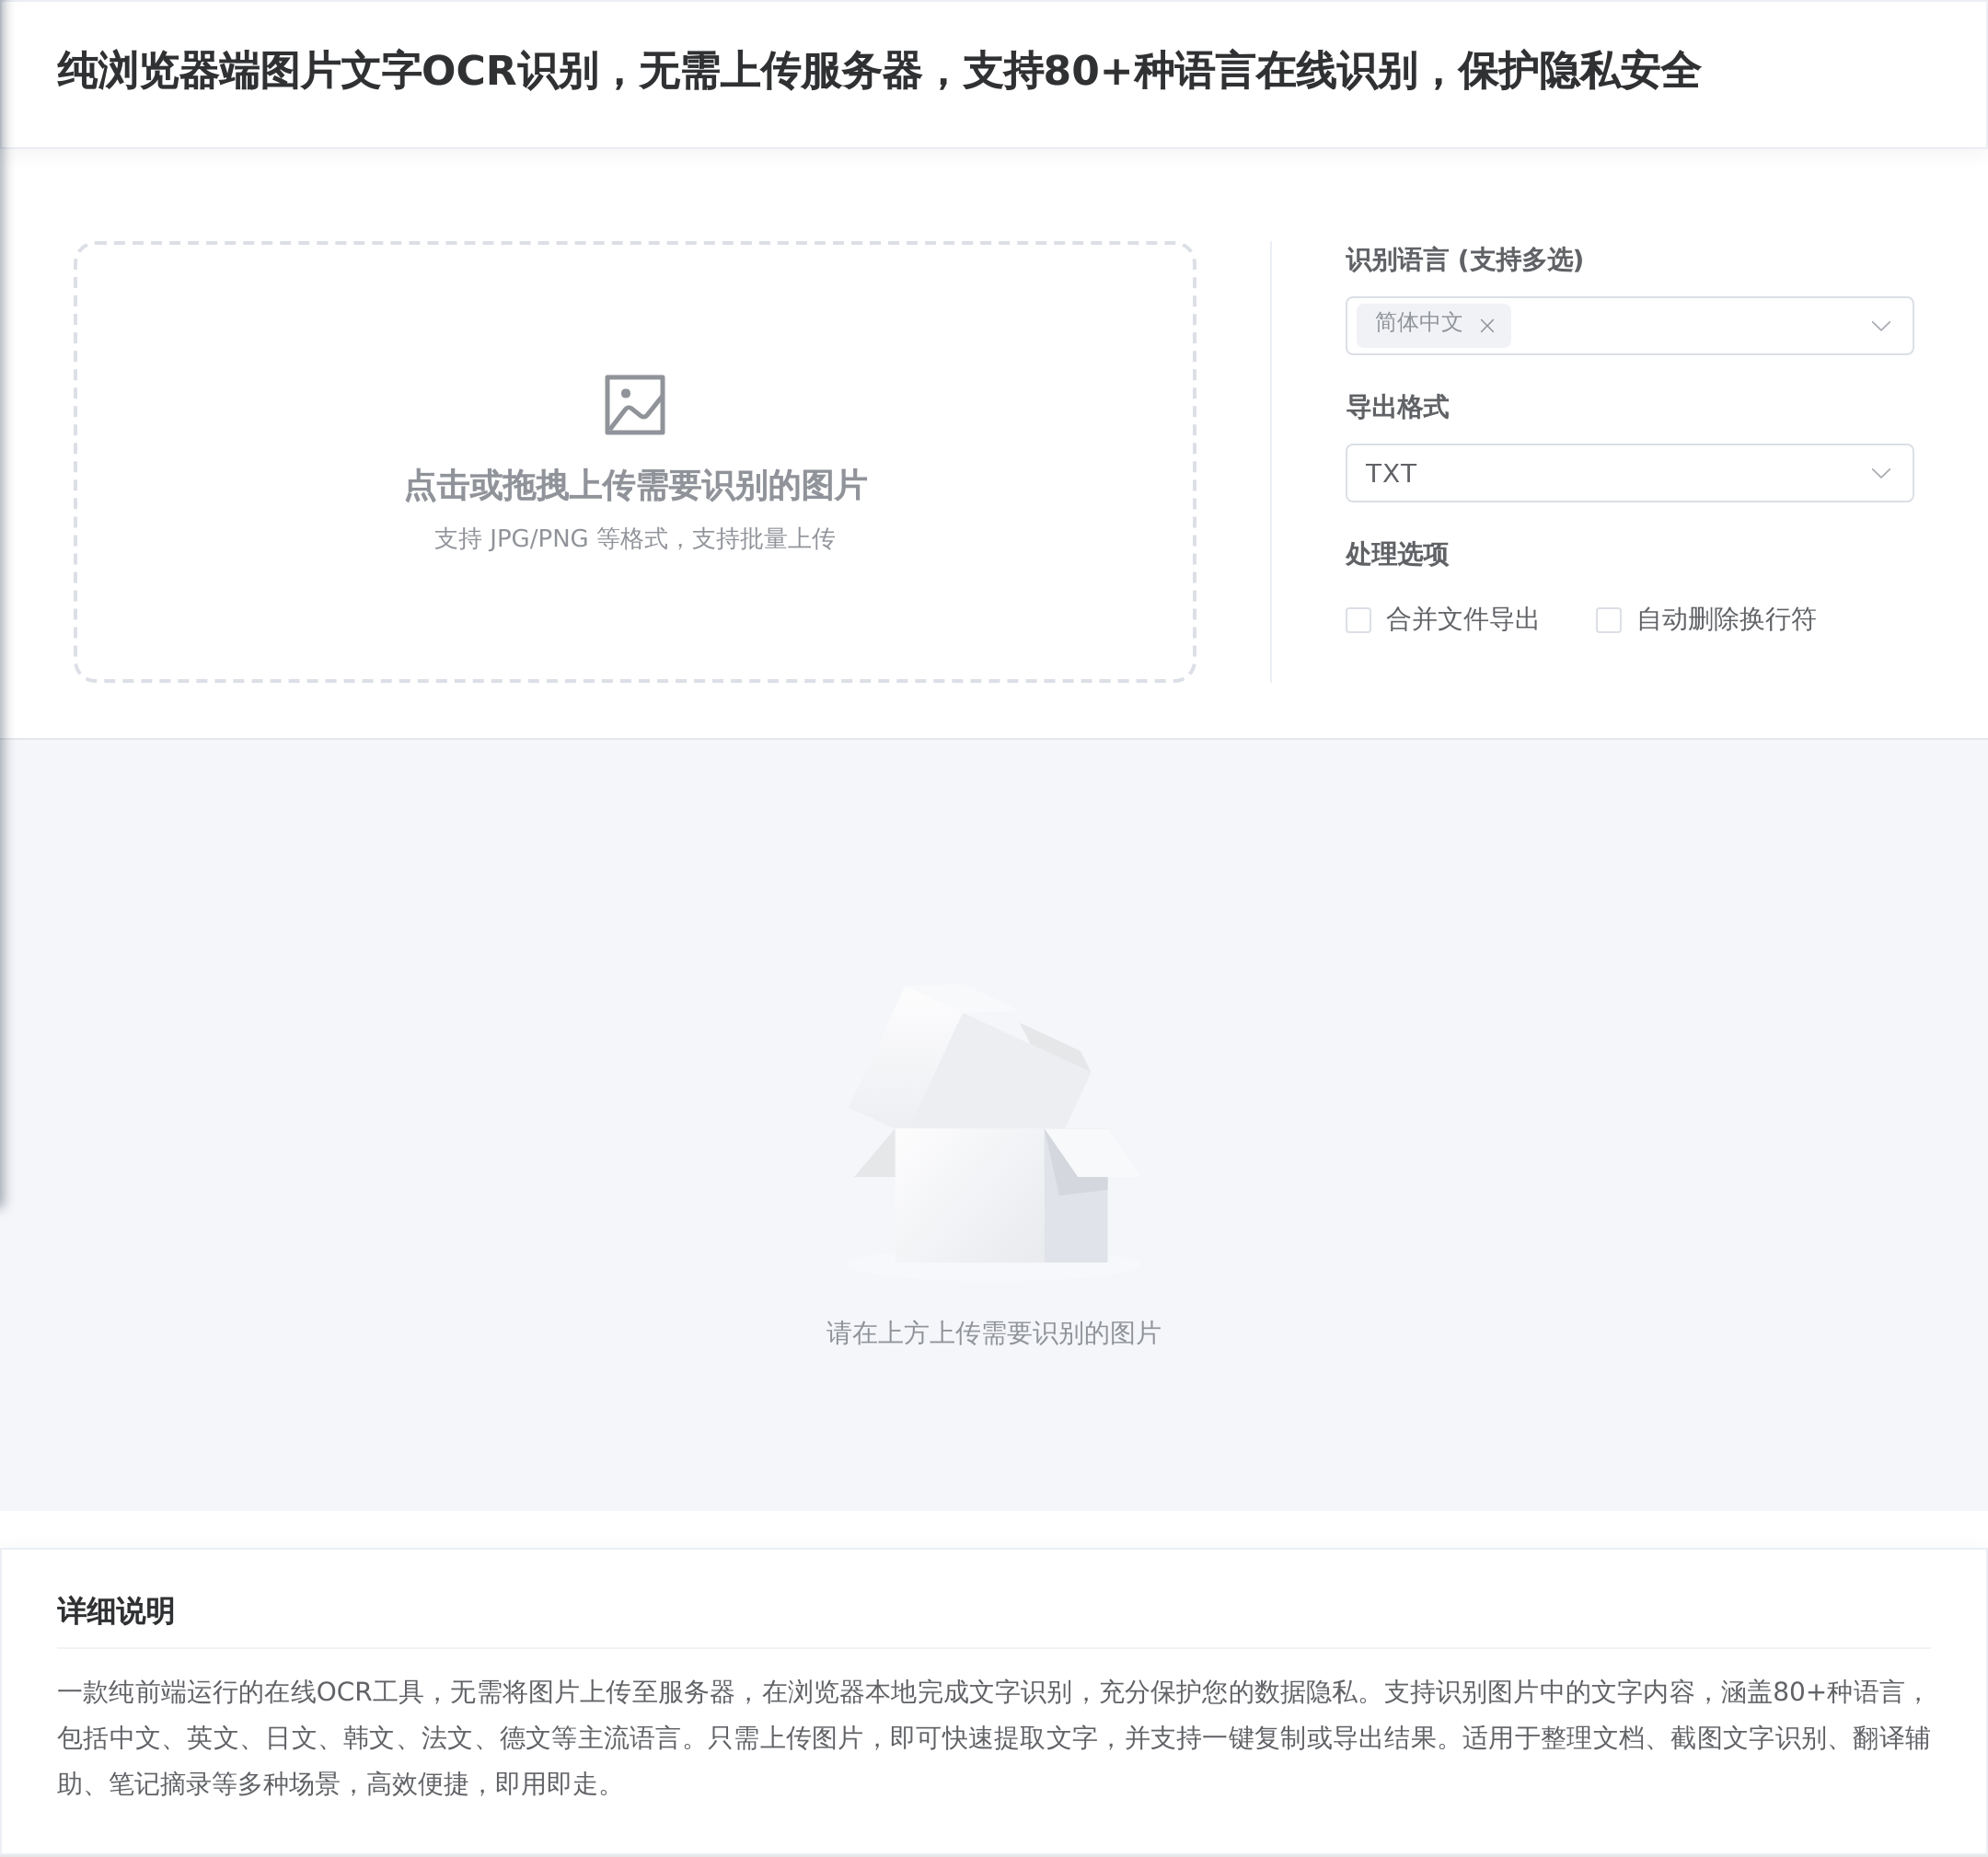
图片OCR在线识别,纯前端处理,无需上传,保护隐私,支持80+种语言。
操作流程简洁高效:
- 上传图片:通过点击或拖拽方式,上传需要识别的JPG或PNG格式图片。工具支持批量上传,可一次性处理多张图片,适合处理成批的票据或合同扫描件。
- 选择识别语言:从下拉菜单中选择一种或多种语言,例如中文、英文、日文等,覆盖80多种全球语言。多语言选项能显著提升识别准确性,尤其对混合语言文档。
- 设置导出和处理选项:配置导出格式(如纯文本或结构化输出),并可启用处理选项如自动删除换行符,以优化文本可读性。这些设置帮助您根据后续使用场景定制输出。
- 开始识别并获取结果:点击识别按钮,工具在浏览器本地快速处理图片,识别出的文字立即显示在界面中。结果可直接一键复制到剪贴板,方便粘贴到文档、笔记或翻译工具中,全程无需网络传输。
纯前端OCR的核心优势
纯前端运行是这款工具的最大亮点。所有图片处理和文字识别都在您的设备上完成,数据从未离开浏览器,彻底消除了上传至服务器带来的泄露风险。这对于处理高度敏感的法律合同或财务记录至关重要,确保符合行业隐私标准。此外,工具支持80多种语言的在线识别,包括主流语言如中文、英文、法文、德文等,以及较少见的语言,提升了多语言文档的处理能力。识别引擎基于先进算法优化,准确率高,能有效处理模糊、倾斜或低分辨率的图片,减少人工校对时间。
进阶技巧:批量处理与多语言优化
对于高效办公,进阶技巧能进一步提升工具效用。利用批量上传功能,您可以一次性处理数十张图片,例如将整个文件夹的票据扫描件导入,工具会顺序识别并输出结果,节省重复操作时间。结合多语言选项,如果文档包含中英文混合内容,选择相应语言组合可以提高识别精度。此外,在处理复杂文档时,尝试调整处理选项如保留或删除换行符,以适应不同的文本格式需求。定期更新浏览器以确保工具兼容性和性能,也能优化体验。
扩展办公流程:推荐相关隐私工具
纯前端OCR工具是隐私安全办公生态的一部分。为了构建更高效的工作流,本站还提供其他注重隐私的工具。例如,RAR转ZIP工具同样在浏览器本地运行,无需上传压缩文件,保护数据安全,适合转换敏感档案。结合这些工具,您可以实现从文档识别到格式转换的全流程隐私保护,提升办公效率。探索更多相关功能,如PDF处理或图片编辑工具,进一步完善您的数字工具箱。